Dans cet article
Le tableau des scores me dit qui a terminé la partie avec le plus de kills. Il explique beaucoup moins bien pourquoi notre jungler est arrivé en retard au dragon, où se trouvait notre support avant le combat ou quelle rotation a laissé la moitié de la carte ouverte.
C’est le problème que je voulais résoudre avec Ward : prendre un replay de League of Legends, en extraire assez d’informations pour reconstituer le match sur une carte, puis rendre cette carte utile pendant une analyse. Revenir à un objectif. Suivre un joueur. Dessiner une autre rotation. Ajouter une note au moment où elle compte.
La partie intéressante se situe entre la sélection d’un fichier .rofl et l’ouverture de cet espace d’analyse. Un replay n’est pas une table de coordonnées de champions prête à interroger. Le jeu expose une partie des informations dont j’ai besoin, la mini-carte en montre une autre, et aucune des deux sources ne fonctionne au rythme idéal pour l’extraction.
Cet article présente le système que j’ai mis au point pour répondre à ces contraintes : l’extracteur Windows, la vision par ordinateur, la synchronisation, l’étalonnage, la reconstruction, le stockage et l’application web. J’y passe également en revue les tests de performance enregistrés, y compris les cas où une vitesse accrue a nui à la qualité du résultat.
Si vous êtes venu ici pour en savoir plus sur l’extraction ROFL : Ward lit la rediffusion via League, capture la mini-carte, combine les positions détectées avec les données locales du jeu, puis génère des enregistrements structurés. Il ne décode pas directement chaque paquet contenu dans le fichier ROFL. Cette distinction explique en grande partie l’architecture.
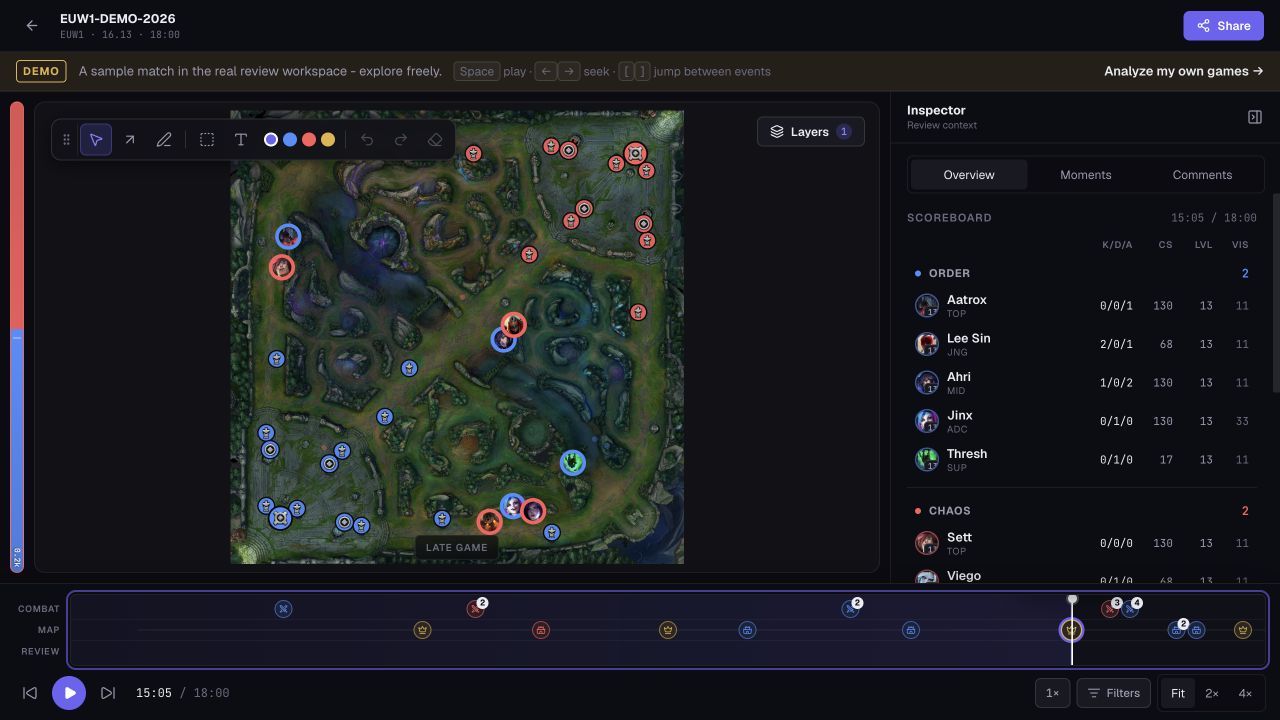
Les captures d’écran montrent la démo publique et son match d’exemple. Elles illustrent la véritable interface d’analyse, pas le replay utilisé pour les benchmarks. Les chiffres ci-dessous proviennent des expériences consignées dans le dépôt ; je ne les ai pas mesurés à nouveau sur un autre matériel pour cet article.
1. De la rediffusion ROFL à un format que l’entraîneur peut analyser
Mon autre projet, invade.lol, explore les statistiques des matchs. Ward va plus loin dans l’analyse d’une partie individuelle. Je voulais conserver la chronologie des événements, et pas seulement le résultat.
Imaginez que vous analysiez la perte d’un dragon. Une interface utile devrait vous permettre de remonter le temps à partir de l’objectif, de voir quels joueurs se trouvaient à proximité et de comparer leurs déplacements avant le combat. Une simple capture d’écran ne suffit pas. Il en va de même pour le fil des éliminations pris isolément. La valeur ajoutée réside dans l’alignement de l’espace, du temps, de l’état des joueurs et des annotations.
Le produit comporte quatre parties principales :
| Partie | Responsabilité | Implémentation |
|---|---|---|
| Extracteur | Lire une rediffusion, échantillonner la mini-carte, générer les positions et l’état de la partie | Python, YOLO11, ONNX Runtime |
| Application desktop | Sélectionner les fichiers, lancer l’extraction, afficher la progression, lire puis envoyer les résultats | Electron et Vue |
| API | Importer les parties, fournir les images et les événements, gérer l’accès et examiner les données | AdonisJS et TypeScript |
| Web | Rejouer la carte extraite, inspecter les événements, dessiner et analyser | Nuxt et Vue |
PostgreSQL conserve les données applicatives. ClickHouse conserve les positions par image et les événements. Ces données répondent à des charges de travail et à des cycles de vie différents, ce qui devient particulièrement important lorsqu’un import échoue en cours de route.
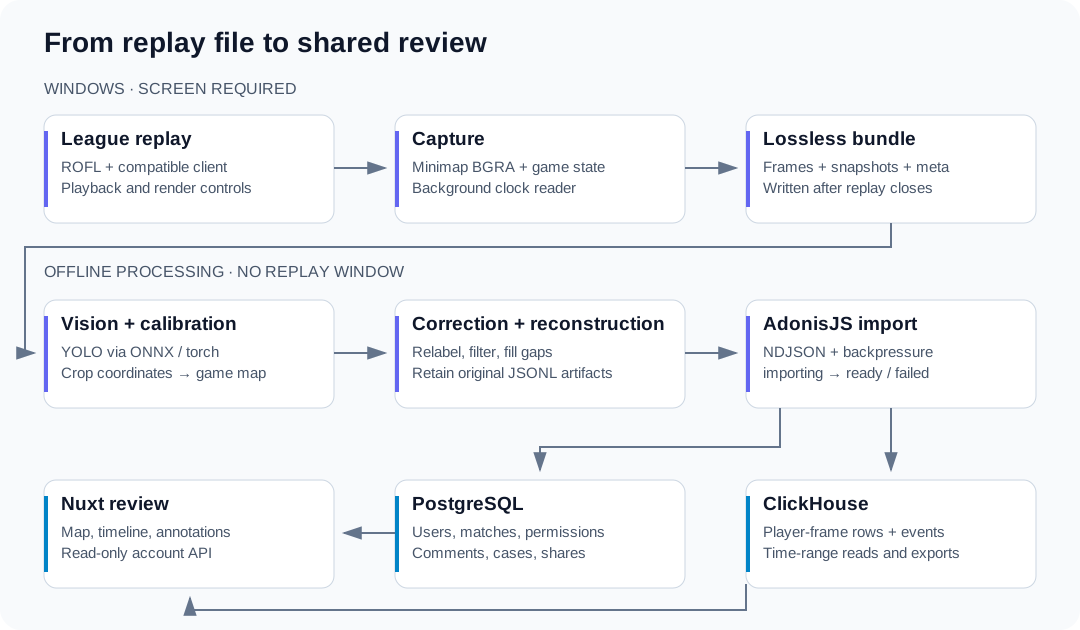
Le travail dépendant de l’écran prend fin après la capture. L’inférence hors ligne doit encore s’achever avant que le match extrait puisse être téléchargé et consulté.
La limite qui m’importe est simple : le navigateur ne doit pas nécessiter l’installation de League. Windows et le client du jeu sont des prérequis pour l’extraction. L’examen des données déjà extraites relève d’une application web.
2. Pourquoi l’extraction ROFL est un problème de fusion de données
Il existe trois interfaces qu’il convient de distinguer. L’API du client League facilite le lancement des rediffusions. L’API locale Live Client Data fournit l’état des joueurs et les événements. L’API Replay contrôle la lecture et le rendu.
L'extracteur utilise les points de terminaison locaux du jeu sur 127.0.0.1:2999. La charge utile « Live Client Data » fournit des informations telles que les noms des champions, les équipes, les niveaux, les scores, l'état de mort et les événements. Les enregistrements par joueur utilisés par Ward ne fournissent pas les coordonnées de la carte nécessaires à la visionneuse. Je les récupère à partir de la mini-carte.
L’API Replay permet à l’extracteur de mettre en pause, de rechercher un passage, de modifier la vitesse et de configurer le rendu. Elle doit être activée dans la configuration locale du jeu. Riot documente les deux interfaces de jeu dans sa référence sur les données du client en direct et l’API Replay.
L’étape de fusion combine donc deux types d’informations :
- État structuré : qui joue, si un joueur est mort, son score et les événements qui se sont produits.
- Observations visuelles : quelle icône de champion est apparue à un emplacement particulier dans le recadrage de la mini-carte.
Aucune de ces deux sources ne remplace l’autre. La vision par ordinateur seule ne peut pas me fournir de manière fiable le score actuel. L’état des joueurs seul ne peut pas m’indiquer de quel côté d’un mur se trouve quelqu’un.
La même distinction s’applique à l’expression « pas de clé API Riot ». Ce chemin d’extraction ne nécessite pas de clé API publique pour développeurs, mais il utilise bel et bien des API client locales. Qualifier l’implémentation dans son ensemble de « sans API » masquerait l’un de ses choix de conception les plus utiles.
Une rediffusion a toujours besoin de son environnement
L’extracteur ne peut pas rendre lisible un replay incompatible. Mon contrôle de compatibilité lit un court préfixe d’en-tête pour récupérer la version des fichiers ROFL reconnus, puis compare les trois premiers composants avec ceux du client installé. Il ignore le dernier composant et évite de signaler une incompatibilité si l’analyse reste incertaine. C’est un contrôle ciblé, pas un décodeur binaire complet du replay. Le fichier ROFL nécessite un patch League compatible. Lors d’un benchmark, j’ai pu capturer un replay avec le patch installé ; pour un autre, je n’ai pu relancer l’analyse qu’à partir d’un bundle déjà enregistré.
De même, la capture d’écran nécessite un bureau en cours de rendu. Un écran en veille, une fenêtre de jeu réduite ou une session à distance déconnectée peuvent générer des images noires. Ward effectue des contrôles préalables pour détecter ces situations, car un millier d’enregistrements JSON d’apparence valide générés à partir d’images noires constituerait un scénario de défaillance particulièrement grave.
L’extracteur désactive également le rendu inutile de l’environnement via les commandes de relecture. Seule la mini-carte importe ; consacrer du temps de calcul du GPU au dessin du reste de la scène n’apporte donc pas grand-chose à l’extraction. Cela aide, mais ne supprime pas tous les effets visuels de la mini-carte elle-même. Cette limitation se reflète directement dans les tests de performance.
3. Le premier goulot d’étranglement était la relecture, et non le réseau neuronal
La boucle d’extraction, très simple, est facile à décrire : mettre en pause, se positionner sur un horodatage, attendre que l’image se stabilise, capturer, inférer, répéter.
Elle est également coûteuse en ressources. Les notes du projet indiquent que chaque opération de mise en pause et de positionnement prend plusieurs centaines de millisecondes. Avec des milliers de points d’échantillonnage par partie, même un détecteur infiniment rapide passerait un temps considérable à attendre le moteur de rediffusion.
C’est pourquoi l’extracteur dispose d’un pipeline de lecture continue. On laisse le replay avancer, on collecte les images sur une grille temporelle du jeu et on effectue l’inférence pendant la lecture. Dans le chemin couplé, un producteur soumet le travail à une file d’attente bornée, des workers détectent les champions et un processus d’écriture rétablit l’ordre chronologique.
Cette dernière étape est indispensable. L’ordre d’achèvement des travailleurs ne correspond pas à l’ordre du jeu. L’image 102 peut se terminer avant l’image 101. L’enregistreur stocke les résultats par index et vide la séquence contiguë suivante, afin que la concurrence ne réorganise pas silencieusement la chronologie.
La file d’attente bornée est également un choix délibéré. Si l’inférence prend du retard, laisser la mémoire croître indéfiniment ne résout pas le problème de débit sous-jacent. Le producteur compte plutôt les points de grille perdus. Les métadonnées qui en résultent rendent la défaillance observable.
Une première approximation de la lecture couplée est la suivante :
playback_speed ≈ inference_frames_per_wall_second × sample_step × headroom
Avec un pas d’échantillonnage d’une demi-seconde de jeu, chaque seconde d’affichage à une lecture 12× nécessite le traitement d’environ 24 images. La marge de manœuvre laisse de la capacité pour la capture, la planification et les variations de latence d’inférence. Le code utilise une mesure de débit plutôt que de supposer que chaque machine peut maintenir le même rythme.
Cela a amélioré le débit, mais le temps pendant lequel League occupait l’écran restait lié au matériel d’inférence de l’utilisateur. C’était le prochain problème à résoudre.
4. L’inférence différée a transformé l’expérience utilisateur
La question pertinente est alors devenue : que doit-il se passer pendant que le replay est visible ?
La capture des pixels doit avoir lieu à ce moment-là. L’exécution du détecteur, en revanche, ne doit pas l’être. Il en va de même pour la compression des images, la correction des trajectoires ou le téléchargement du résultat.
Le parcours différé effectue donc un petit passage de capture, ferme la rediffusion, puis analyse les données capturées hors ligne. Dans le code actuel pour ordinateur de bureau, c’est le comportement par défaut : il lance l’extracteur avec l’option --defer-inference, un pas d’échantillonnage de 0.5 seconde, la correction et la reconstruction activées, sauf si ces paramètres sont explicitement redéfinis.
C’est le réglage par défaut actuel de l’application desktop. Mes premières mesures utilisaient un autre réglage, donc je précise toujours la configuration testée lorsque je compare les résultats.
La boucle de capture stocke en mémoire les octets bruts de la mini-carte BGRA avec le dernier instantané du joueur et les événements nouvellement observés. Après la capture, le générateur de paquets convertit et encode les images. Un paquet se présente comme suit :
match.bundle/
  bundle.meta.json
  frames.jsonl
  frames/
    000000.webp
    000001.webp
    ...
L'encodage des images se fait au format WebP sans perte, avec un format PNG de secours. C'est précisément avec ces minuscules icônes de champions qu'un format intermédiaire avec perte peut poser problème. Si je modifie les pixels tout en les conservant, une comparaison ultérieure des paramètres du modèle n'utilisera plus les mêmes données d'entrée.
Un ensemble enregistré rend les expériences bien plus utiles. Je peux modifier le seuil de confiance, la taille de l’inférence ou le modèle, puis analyser à nouveau les mêmes pixels capturés. Je n’ai pas besoin de rejouer la partie pour chaque expérience, et une mise à jour ultérieure du client n’invalide pas les pixels déjà capturés.
Le stockage sans perte préserve les données d’entrée des images. Il ne garantit toutefois pas des résultats identiques entre différents backends, révisions de modèles ou paramètres numériques. Ceux-ci nécessitent leurs propres vérifications.
Le fait de sortir le travail de la boucle a un coût en mémoire
L’implémentation de la capture différée accumule les images en mémoire vive avant d’écrire le bundle. Cela évite la latence liée au disque et à l’encodage pendant la capture, mais l’utilisation de la mémoire augmente avec la durée de la partie.
Pour un recadrage BGRA de 255 × 255, une image brute pèse 255 × 255 × 4 = 260,100 octets. Une partie de 30 minutes échantillonnée deux fois par seconde contient environ 3 600 images, avant les suppressions et les conventions de fin de partie. Les pixels bruts occupent donc à eux seuls environ 893 Mio. Une partie d’une heure représente environ le double de ce volume, avant d’ajouter les objets Python et les instantanés des joueurs.
Il s’agit là de tailles de stockage calculées, et non du RSS de pointe mesuré. Elles illustrent un véritable compromis : réduire la durée d’affichage à l’écran transfère la charge vers la mémoire et le traitement hors ligne qui s’ensuit. Un futur spool limité devrait maintenir la compression et le travail sur disque en dehors du chemin de capture, tout en gérant un enregistreur qui prend du retard.
5. Éviter que les requêtes HTTP ne dépassent le budget en millisecondes
L’inférence différée ne suffisait pas à elle seule. Une requête HTTP sur localhost peut encore s’avérer trop lente lorsque la relecture s’exécute rapidement.
À une vitesse de lecture de 12× et un pas d’échantillonnage de 0.5 seconde, le budget en temps réel entre deux échantillons est d’environ 41,7 ms. À 32×, il est de 15,6 ms. Une requête prenant des centaines de millisecondes sous la charge du rendu s’étend sur de nombreux échantillons prévus.
J’ai observé d’importantes pertes d’images à grande vitesse lorsque je lisais le temps de lecture par HTTP pour chaque point de la grille. J’ai déplacé ces lectures vers un thread d’arrière-plan et estimé le temps de jeu entre deux mises à jour.
L'estimation centrale est la suivante :
estimated_game_time = observed_game_time + (
    current_wall_time - observed_wall_time
) * estimated_playback_speed
Le lecteur met à jour l’observation. Le producteur en tire des extrapolations. Le code actuel estime également la vitesse de lecture réelle à partir d’observations consécutives et lisse les estimations acceptées, car la vitesse demandée et la vitesse maintenue ne sont pas toujours identiques.
Il existe ici un mode de défaillance subtil. Une horloge extrapolée peut continuer d’avancer même lorsque le jeu se fige. Ward vérifie les blocages par rapport à l’horloge de référence du lecteur, et non pas simplement par rapport à l’extrapolation. Sinon, l’extracteur pourrait continuer à enregistrer des images répétées avec des horodatages de plus en plus fictifs.
La sortie conserve à la fois t, le point de grille prévu, et game_time, le temps associé à l’observation. Pour la capture différée, cette dernière valeur est basée sur l’estimation de l’horloge. L’état du joueur correspond à l’instantané d’arrière-plan le plus récent disponible. Il ne s’agit pas d’un instantané atomique du moteur de jeu.
Cela a son importance lors de l’interprétation des résultats en demi-seconde. Une grille cible de 0.5 seconde décrit la densité requise. Elle ne garantit pas une précision de synchronisation à la demi-seconde près, en particulier à grande vitesse. L’ancienneté de l’API, l’erreur d’extrapolation, le rendu et le timing de la capture sont autant de facteurs qui entrent en ligne de compte.
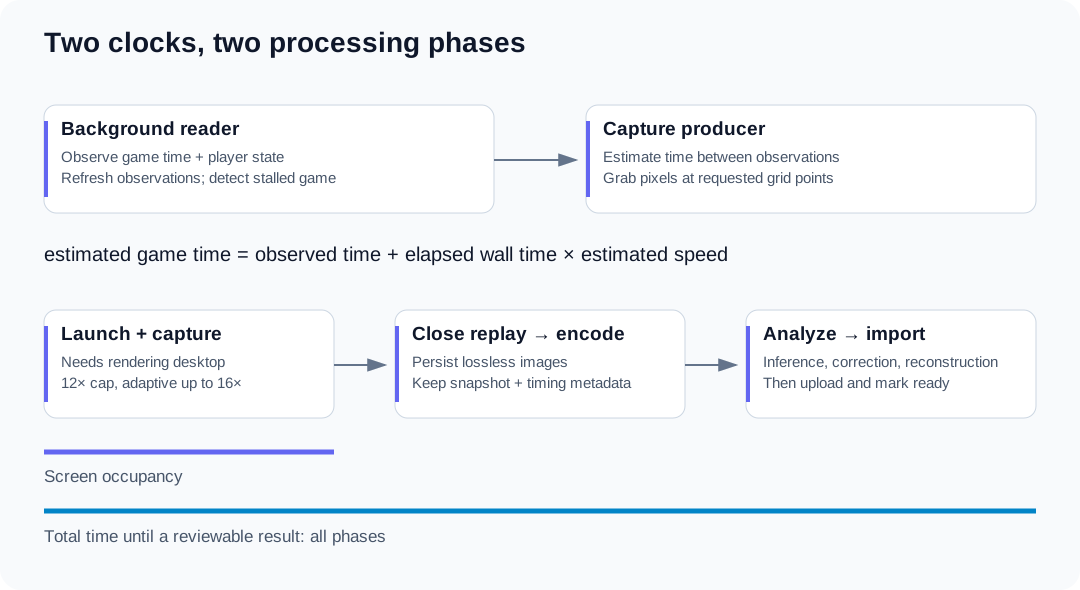
La densité d’échantillonnage, la fidélité de l’horodatage, le temps d’affichage à l’écran et le temps de traitement final sont des mesures distinctes. L’optimisation de l’une d’entre elles n’améliore pas automatiquement les autres.
6. Détecter le bon champion, pas simplement une icône
Ward utilise un détecteur de minimap YOLO11. Le modèle par défaut est yolo11l-minimap, et ses noms de classes doivent être mis en correspondance avec ceux provenant du jeu.
Je n'ai pas entraîné ces poids d'origine. Ils proviennent du modèle de détection de la mini-carte de League of Legends de boboyes. Mon travail ici porte sur le système d’extraction environnant, l’intégration en temps réel, le filtrage, l’étalonnage, la correction et le produit final. La fiche du modèle précise qu’il s’agit d’une licence non commerciale ; la conversion des poids au format ONNX n’efface pas cette condition.
Utiliser la composition d’équipe comme contrainte
Le match m’indique déjà quels champions sont présents. Il n’y a guère de raison de demander au modèle de choisir librement parmi toutes les classes alors qu’un petit sous-ensemble seulement peut être correct.
Ward associe les champions présents dans la partie aux classes du modèle et limite la détection à ces classes. Cela réduit les identifications impossibles et permet d’ajuster le seuil de confiance dans un ensemble de candidats plus pertinent. Dans une expérience, la couverture des images s’est améliorée après l’ajout de cette contrainte. Je ne suppose pas que le même gain s’applique à tous les patchs et à toutes les compositions.
La normalisation des noms est tout aussi importante que le filtre de classe. Une divergence entre l’étiquette d’un modèle et le nom d’une API ne devrait pas transformer une détection valide en un joueur non identifié. Un module de noms partagés garantit la cohérence entre la détection et l’assemblage des enregistrements.
Une entrée de modèle plus grande n’était pas automatiquement meilleure
Le recadrage mesure environ 255 pixels de large dans l’étalonnage documenté. Le redimensionner à 640 pixels ne crée pas de nouvelles informations visuelles. Cela augmente toutefois le nombre de pixels d’entrée d’environ 640² / 256² = 6.25.
Pour choisir automatiquement la taille d’entrée, l’extracteur arrondit la plus grande dimension du recadrage au multiple supérieur du pas du modèle, dans une plage définie. Un recadrage de 255 pixels devient donc une entrée de 256 pixels. Lors d’un essai en conditions réelles, des entrées plus grandes ont nui à la couverture de ce modèle : davantage de pixels ne signifiaient pas de meilleurs résultats.
Deux observations différentes s’imposent ici. Le rapport du nombre de pixels est arithmétique. L’effet sur le débit et la qualité de la détection doit être mesuré. Le coût de la convolution, l’implémentation du backend et la distribution d’entraînement du modèle empêchent qu’un simple rapport de pixels ne garantisse un gain de vitesse.
Les choix de miroirs nécessitent un autre signal d’identification
Une classe de champion ne correspond pas toujours à un joueur unique. Si le même champion apparaît dans les deux équipes, l’implémentation utilise la bordure bleue ou rouge de l’icône pour aider à distinguer ORDER et CHAOS.
C’est un bon exemple de signal propre au jeu qui évite de demander au détecteur de résoudre seul chaque problème d’identité. Il a ses limites : une bordure illisible ne suffit pas à attribuer une équipe avec certitude, surtout lorsque les deux équipes ont choisi le même champion.
7. Calibrage : un point plausible peut tout de même se trouver au mauvais endroit
Le détecteur fournit le centre d’un rectangle normalisé à l’intérieur du cadrage. Le système de révision a besoin des coordonnées du jeu. Une implémentation tentante consiste à mapper directement les bords du cadrage sur les limites de la carte et à inverser l’axe vertical.
Cela produit un résultat d’apparence convaincante, mais les marges de la mini-carte et l’alignement du cadrage rendent cette hypothèse peu fiable. Une transformation incorrecte peut décaler systématiquement toutes les observations. Le lissage temporel ne permettra pas d’y remédier.
Ward ajuste une transformation linéaire indépendante pour chaque axe à partir de repères connus :
game_x = ax × normalized_x + bx
game_y = ay × normalized_y + by
Le coefficient vertical est généralement négatif, car les coordonnées à l'écran augmentent vers le bas. Les coordonnées du jeu utilisent le sens vertical inverse pour cette carte.
Deux points distincts sur chaque axe définissent une ligne. Un plus grand nombre de points de repère permet un ajustement par la méthode des moindres carrés, et ces points doivent être répartis sur l'ensemble de la carte. Des points regroupés dans une petite zone rendent l'extrapolation peu fiable. L'implémentation rejette les ajustements dégénérés dans lesquels un axe ne varie pas suffisamment.
À titre d’exemple de calcul, prenons les coordonnées normalisées (0.08, 0.92) et (0.92, 0.08), associées aux coordonnées du jeu (1400, 1400) et (13500, 13500). L'échelle horizontale ajustée est d'environ 14,404.76 unités de jeu par unité normalisée. L'échelle verticale a la même amplitude mais le signe opposé. Il s'agit d'exemples de points d'étalonnage ; cela ne signifie pas que chaque configuration utilise exactement ces coefficients.
La transformation inverse est tout aussi utile. Ward projette les repères en arrière-plan sur la superposition de la mini-carte, ce qui me permet de vérifier si l’étalonnage place bien un point connu à l’endroit qui lui correspond. Ce test porte sur un aspect différent de celui consistant à vérifier si le détecteur a placé un point au centre d’une icône.
Les métadonnées comportent un indicateur « calibrated ». La reconstruction à partir de repères absolus est conditionnée à une partie calibrée sur Summoner’s Rift. Les calculs relatifs peuvent toujours utiliser les positions observées, mais je ne dois pas associer de coordonnées précises de fontaine ou d’objectif à une transformation inconnue.
8. La correction et la reconstruction résolvent des problèmes différents
Les données brutes présentent des lacunes. Les icônes se chevauchent pendant les combats, les effets visuels les masquent, et les classificateurs attribuent parfois une identité erronée. La réponse ne doit pas consister à rendre silencieusement chaque ligne apparemment complète.
Ward conserve séparément les artefacts bruts, corrigés et reconstruits. Cela permet au pipeline d’enregistrer à la fois les améliorations et les hypothèses.
La correction s’appuie sur des observations
La passe de correction comprend le réétiquetage temporel, le rejet des valeurs aberrantes, l’interpolation et la déduplication des événements.
Le réétiquetage temporel construit des pistes à partir des résultats classés par ordre chronologique et utilise les votes « champions » pour corriger les erreurs d’étiquetage ponctuelles. Ce processus intervient après l’extraction, car les nœuds d’inférence indépendants ne constituent pas un système de suivi unique et continu. Une étape de post-traitement permet de prendre en compte le contexte chronologique dont un nœud individuel ne dispose pas.
Le filtre des valeurs aberrantes est de type Hampel : il compare un point à ses positions voisines et rejette les écarts suffisamment importants. Il s’agit d’un filtre spatial pragmatique, et non d’un simulateur de mouvement complet. Cette distinction est importante en ce qui concerne les dashes, les téléportations et les rappels.
L’interpolation nécessite deux points d’ancrage. Si un champion a été observé en point A puis en point B, le correcteur peut combler un court écart lorsque l’état de mort et les contraintes de mouvement le permettent :
alpha = (t - tA) / (tB - tA)
position(t) = A + alpha × (B - A)
Un segment de ligne correspond à une estimation du trajet manquant. Il ne prouve pas que le joueur ait marché en ligne droite ou traversé un terrain praticable. Les limites de vitesse maximale et d’écart définies par le code constituent des filtres de plausibilité, et non une connaissance exhaustive de toutes les capacités de déplacement.
La reconstruction utilise un contexte supplémentaire
Un écart ne disposant d’aucun deuxième repère visuel ne peut être comblé par une interpolation classique. La reconstruction intègre des événements et des états : les participants impliqués dans un kill, les emplacements des objectifs, les positions récentes, les réapparitions et l’état de mort.
Par exemple, un participant détecté près d’un kill peut fournir un repère spatial pour un participant invisible. Un événement lié à un objectif peut fournir un repère de fosse lorsque la carte est calibrée. Une observation récente peut étayer une estimation de maintien de position de courte durée ou de mouvement limité.
Il s’agit là d’heuristiques utiles, mais un « kill » ne place pas logiquement tous les participants exactement aux mêmes coordonnées. Les capacités à distance, les dégâts à longue portée et les assists en sont des contre-exemples évidents. Le code de reconstruction contient donc des informations sur la source, le niveau de confiance et l’incertitude. Ses rayons d’incertitude sont des valeurs heuristiques, et non des intervalles de confiance calibrés statistiquement.
Les joueurs morts peuvent être représentés au niveau de la fontaine de leur équipe. Il s’agit d’une convention de visualisation pour un joueur inactif, et non d’une mesure de l’emplacement d’un cadavre. Cela permet d’augmenter la couverture des « positions non nulles » sans ajouter de nouvelle observation de mouvement.
Pourquoi le maintien de la dernière position est-il bidirectionnel ?
La mise à jour du 1er juillet remplace un simple maintien de la dernière position par une estimation bidirectionnelle. L’analyse hors ligne peut utiliser une observation juste après une lacune ainsi qu’une observation juste avant celle-ci. Chaque point manquant correspondant à un joueur vivant prend en compte des points de repère provenant des deux directions et sélectionne le plus proche.
Lorsque deux points d’ancrage proches indiquent une vitesse de marche plausible, l’estimation est projetée le long de ce vecteur. L’implémentation rejette les paires obsolètes datant de plus de quatre secondes, les vitesses supérieures à 700 unités de jeu par seconde, et limite le déplacement projeté à 1 500 unités. Il s’agit là de limites heuristiques actuelles, et non de garanties de mouvement mesurées.
Le niveau de confiance diminue toujours avec le temps à partir du point d’ancrage, tandis que l’incertitude augmente. Il est essentiel de noter que les points d’ancrage déduits ne deviennent pas de nouveaux points d’ancrage pour une chaîne d’extrapolation sans fin, et qu’une mort réinitialise la marche. Sans cette règle, une supposition pourrait justifier à plusieurs reprises la supposition suivante et dériver à travers la carte avec une continuité apparente.
J’utilise aussi des points d’ancrage de réapparition : une transition récente entre la mort et la réapparition peut fournir une position à la fontaine sur une carte calibrée. Là encore, la fenêtre temporelle doit rester courte. « Vivant maintenant » ne signifie pas « encore à la fontaine ».
L'invariant important est que la reconstruction comble les positions manquantes plutôt que de remplacer les détections existantes. Un utilisateur peut alors choisir d'inclure ou non event_assist, hold, dead ou d'autres sources déduites dans une analyse.
La provenance doit être préservée tout au long du pipeline
L’extracteur est plus expressif qu’un simple booléen indiquant « la position existe ». Cependant, le mappage d’ingestion actuel illustre également à quel point ce détail peut facilement être perdu : il se ramifie sur detection.inferred, tandis que les enregistrements interpolated et relabeled du correcteur comportent une source dépourvue de cet indicateur. Ces enregistrements peuvent par conséquent être normalisés en cv lors de l’ingestion. Le schéma positionnel de ClickHouse ne conserve pas non plus le rayon d’incertitude de reconstruction.
Pour l’analyse comparative ci-dessous, j’utilise les artefacts de l’extracteur et la ventilation des sources du rapport, sans prétendre que le nombre de cv dans le cloud correspond à une détection brute pure. Si je devais mener une étude rigoureuse sur la précision en aval, la préservation de ces distinctions de bout en bout serait une condition préalable. C’est exactement la raison pour laquelle je conserve les fichiers d’extraction d’origine.
9. Tests de performance pour l'extraction de replays : la limite de vitesse est visuelle
L'expérience la plus utile du référentiel est BENCHMARK_ONSCREEN_TIME.md, datée du 1er juillet 2026. Elle compare la capture différée à des taux de 8×, 12×, 16× et 32×.
Le balayage en direct a utilisé une partie de 926 secondes, le patch client 16.13.791.5903, un pas d'échantillonnage de 0,5 seconde et conf=0.25. L’inférence hors ligne a été réalisée avec une RTX 3070, Python 3.11.9, Torch 2.7.0+cu126 et la demi-précision CUDA. L’entrée du modèle a été recadrée à environ 256 pixels, avec des classes contraintes par la liste des joueurs.
Cet environnement a son importance. Il ne s’agit pas de mesures du backend DirectML fourni tel quel sur la machine de chaque utilisateur. Il s’agit de résultats enregistrés pour une configuration spécifique de capture et d’analyse. Le rapport ne fournit pas de distributions sur plusieurs essais ni de centiles de latence ; je n’ajoute donc pas de barres d’erreur fictives.
Temps et perte d’échantillonnage
| Lecture | À l’écran | Du lancement à la fermeture | Images capturées | Points de grille perdus |
|---|---|---|---|---|
| 8× | 127,0 s | 136,3 s | 1 772 | 93 (5,0 %) |
| 12× | 87,5 s | 96,3 s | 1 739 | 126 (6,8 %) |
| 16× | 68,2 s | 78,9 s | 1 666 | 199 (10,7 %) |
| 32× | 36,1 s | 45,1 s | 1 491 | 374 (20,1 %) |
Source : rapport de capture du 1er juillet du référentiel, rediffusion KR de l’intégralité du match. La période « du lancement à la fermeture » prend fin lorsque la rediffusion se termine ; l’inférence hors ligne et le téléchargement sont exclus. Les nombres d’images et de pertes sont indiqués tels qu’enregistrés, et non recalculés à partir de la durée arrondie de 926 secondes.
Le réglage 12× a réduit le temps d’affichage à l’écran d’environ 31 % par rapport au réglage 8× lors de ce test. Il ne l’a pas divisé par deux. Avec le réglage 32×, la rediffusion a disparu beaucoup plus tôt, mais environ un point programmé sur cinq a été omis.
Couverture des images de joueurs capturées
| Lecture | Couverture CV brute | Couverture reconstruite |
|---|---|---|
| 8× | 81,5 % | 98,3 % |
| 12× | 81,5 % | 98,1 % |
| 16× | 77,7 % | 96,2 % |
| 32× | 60,0 % | 85,9 % |
Le rapport définit la couverture comme le nombre d’images de joueurs ayant une position non nulle, divisé par le nombre d’images capturées, multiplié par dix. Il ne mesure pas la distance entre les coordonnées prédites et les coordonnées réelles. Il n’inclut pas non plus les images perdues dans ce dénominateur.
Cela rend cette méthode utile, mais insuffisante à elle seule. Un système peut améliorer la couverture conditionnelle en ne conservant que les images faciles. Pour une évaluation complète, je souhaite disposer à la fois de la perte d’échantillonnage, de la couverture et de l’erreur spatiale.
À titre d’illustration dérivée, multipliez la fraction de grille conservée par la couverture reconstruite : la série 12× représente environ 91,5 % des points de grille prévus pour les joueurs, tandis que la série 32× en représente environ 68,7 %. Ce calcul suppose dix joueurs à chaque point de la grille et utilise les pourcentages de couverture arrondis du rapport. Il s’agit d’une estimation de la disponibilité, et non de la précision.
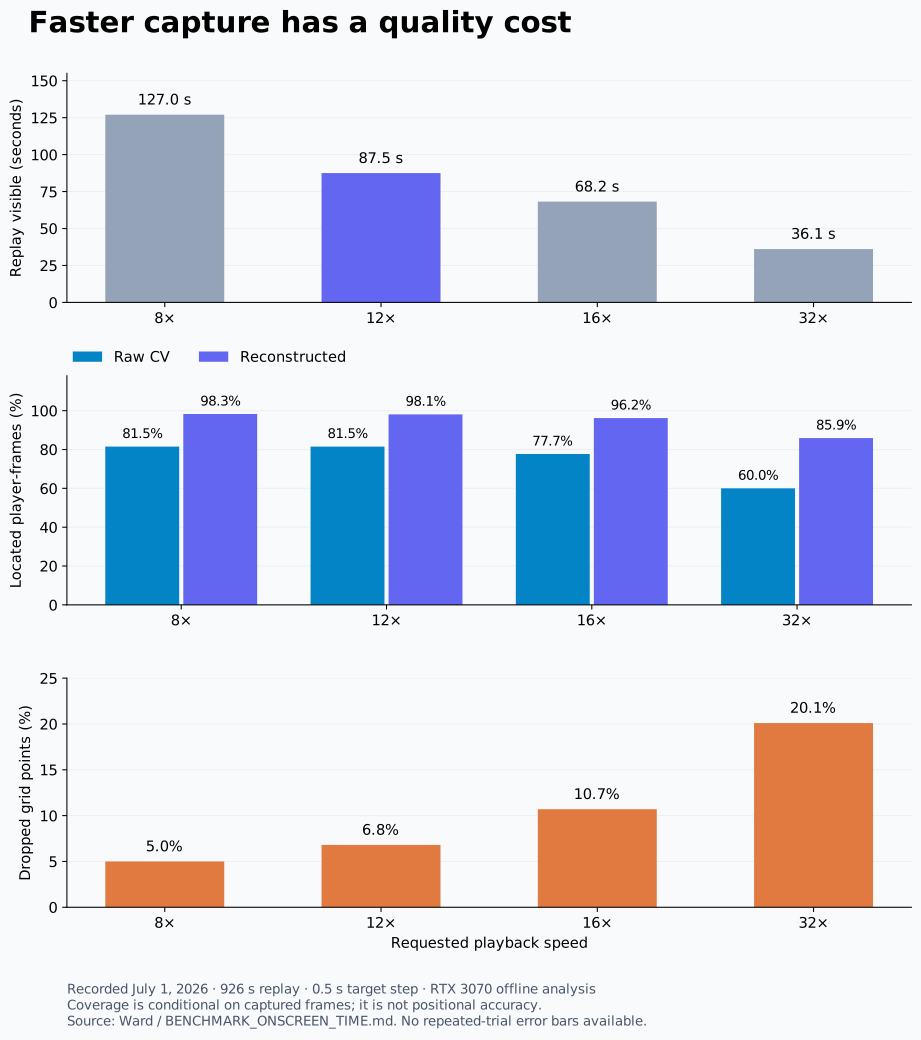
Télécharger les mesures enregistrées au format CSV. Les graphiques reproduisent les mesures enregistrées. La couverture dépend des images capturées. Un pourcentage de couverture reconstituée plus élevé signifie moins de positions nulles, et non des coordonnées vérifiées de manière indépendante.
Une fenêtre difficile révèle une réalité différente
Le rapport évalue également la fenêtre fixe de « 540 à 660 s ». Cela permet d'éviter de juger le système uniquement sur la base d'images calmes du début de partie et de positions de fontaine impeccables.
| Lecture | Couverture brute | Corrigée | Reconstruite |
|---|---|---|---|
| 8× | 82,7 % | 93,6 % | 100,0 % |
| 12× | 84,8 % | 93,2 % | 100,0 % |
| 16× | 78,0 % | 89,1 % | 96,5 % |
| 32× | 45,2 % | 59,0 % | 75,4 % |
À grande vitesse, des anneaux générés par l’action s’accumulent sur la mini-carte et masquent les icônes. Les notes du projet mentionnent des tentatives d’utilisation de drapeaux de rendu, sans qu’aucun ne permette de supprimer cet effet. Le moteur peut faire avancer l’horloge du jeu plus rapidement qu’il ne peut produire des images tout aussi utiles pour le détecteur.
C’est cette distinction qui a motivé le changement de la valeur par défaut : la rediffusion jouable la plus rapide n’est pas nécessairement l’extraction utilisable la plus rapide.
La composition des sources évolue également. Parmi les positions localisées des joueurs, le rapport indique que les détections directes représentent environ 75 % à 8× et 62 % à 32× ; les détections faibles passent d’environ 0 % à 5 %. Ces pourcentages portent sur un autre dénominateur, le sous-ensemble localisé. Il ne faut pas les confondre avec la colonne « couverture brute » ci-dessus.
Fonctionnement réel des paramètres par défaut
L’implémentation actuelle utilise une limite de capture différée de 12×, avec une augmentation adaptative en fonction de la durée jusqu’à un plafond fixe de 16×. Le choix automatique tient également compte du débit de capture mesuré. Une modification explicite de la vitesse est un choix distinct.
L’objectif est de maintenir l’occupation de la mémoire de relecture à un niveau gérable sans entrer dans la forte baisse de qualité observée à 32×. Il ne s’agit pas d’une garantie universelle de cinq minutes. Les parties très longues, les chargements lents, un rendu médiocre et les machines atypiques peuvent dépasser cet objectif.
Le rapport contient une nouvelle analyse hors ligne d’un ancien enregistrement EUW. Il s’agit d’une confirmation utile, mais deux cas d’enregistrement ne constituent pas une preuve valable pour toutes les compositions, tous les correctifs, toutes les résolutions ou tous les matériels. J’aurais besoin d’un corpus plus large, avec des captures répétées, pour affirmer cela.
10. ONNX Runtime : la distribution faisait partie des performances
Faire fonctionner le modèle sur ma machine de développement n’était qu’une partie du travail. Pour proposer une application Windows utilisable, il fallait également réfléchir au runtime que les utilisateurs devraient télécharger.
L’ancien bundle CUDA et Torch pesait environ 2,5 Go. Le passage à ONNX Runtime a ramené le runtime à quelques centaines de mégaoctets. Ces chiffres correspondent aux versions mesurées, pas à une taille exacte garantie pour chaque livraison.
Le runtime privilégie les fournisseurs disponibles dans l’ordre suivant : CUDA, DirectML, puis CPU. La version Windows universelle utilise DirectML ; l’inférence n’est donc pas limitée à une installation CUDA. La chaîne d’outils d’exportation de modèles d’origine reste un enjeu au moment de la compilation.
L'adaptateur ONNX expose la petite interface déjà utilisée par le détecteur : résultats de prédiction avec des rectangles, des classes, un niveau de confiance, des coordonnées normalisées et des noms de classes. Cela permet d'éviter que l'assemblage des enregistrements ne soit affecté par des ramifications spécifiques au backend.
Le prétraitement et le décodage restent essentiels. L'adaptateur implémente le letterboxing, la normalisation des tenseurs, le décodage de la sortie et la suppression des valeurs non maximales. Une exportation ONNX numériquement valide ne suffit pas si le prétraitement déplace l’icône sans le signaler ou si le décodage interprète le mauvais axe.
Les tests de parité distinguent la fidélité du graphe brut du comportement de décodage de bout en bout. Ils comparent des tenseurs d’entrée identiques pour la vérification du graphe et utilisent une taille d’image contrôlée pour la vérification du décodage. Ces tests nécessitent des modèles réels et les environnements d’exécution correspondants ; la suite allégée les ignore lorsque ces dépendances sont absentes.
J’ai aussi rencontré un problème de concurrence. DirectML ne prend pas en charge plusieurs appels Run simultanés sur une même session, comme le précise la documentation ONNX Runtime DirectML. Après des plantages avec plusieurs workers, je suis passé à une seule session d’inférence ONNX. Un nombre de workers adapté au CPU peut être un mauvais choix pour un fournisseur GPU.
Sur une machine équipée d’une RTX 3070, j’ai relevé environ 16 ms par inférence avec DirectML, contre 59 ms sur CPU. Le benchmark du fournisseur utilise un recadrage synthétique reproductible de 256 × 256, trois appels de préchauffage et, par défaut, 200 itérations chronométrées. Il vérifie le fournisseur réellement chargé : un repli silencieux sur le CPU n’est donc pas compté comme un résultat DirectML. C’est un micro-benchmark du runtime. Des pixels synthétiques ne mesurent pas la qualité de détection des champions. Je le distingue du test de capture de juillet : un benchmark d’inférence n’inclut ni le lancement du replay, ni la capture, ni l’encodage du bundle, ni la correction, ni l’envoi. Il ne donne pas un temps complet « par replay ».
11. Diffusion des résultats vers deux bases de données
Un intervalle d’échantillonnage d’une demi-seconde produit environ 36 000 lignes de joueurs pour un match de 30 minutes à dix joueurs avant les pertes de données. Il s’agit d’un nombre de lignes calculé, et non d’une affirmation concernant le trafic en production. Cela suffit pour qu’il vaille la peine de réfléchir dès le début à la structure des données et à leur diffusion en continu.
Le format de transmission pour l’importation est du JSON délimité par des sauts de ligne. La première ligne est une enveloppe de métadonnées. Les lignes suivantes sont des enregistrements d’images :
{"meta":{"extractor_version":"0.2.0","map":{"number":11},"calibrated":true}}
{"t":540.0,"game_time":540.2,"players":[{"champion":"Ahri","team":"ORDER","isDead":false,"map_position":{"x":5400,"y":8100},"detection":{"conf":0.91}}],"events":[]}
Charge utile illustrative montrant un seul joueur. Une partie classique à dix joueurs comporte les dix emplacements de joueurs stables dans chaque trame, y compris les joueurs dont la map_position est nulle. Les valeurs ci-dessus expliquent le format de transmission ; elles ne constituent pas une observation issue d’un benchmark.
L’API lit le corps ligne par ligne et le répartit en flux de positions et d’événements. La contre-pression est importante : si une destination ne peut pas accepter une autre ligne, le producteur attend le drain. La fonction d’aide écoute également les événements « close » et « error », de sorte qu’un échec d’insertion n’entraîne pas une attente indéfinie de la requête pour un « drain » qui n’aura jamais lieu.
La validation porte sur la version prise en charge de l’extracteur, un nombre stable de joueurs, des étiquettes d’équipe valides, les durées de partie et une limite d’images. La conversion numérique est limitée aux types de stockage. Il s’agit d’une mesure d’hygiène de l’ingestion, et non d’une preuve que chaque coordonnée soumise est exacte.
PostgreSQL gère l’état de l’application
Les utilisateurs, les matchs, les enregistrements d’accès, les commentaires, les cas de révision et le partage relèvent de la couche applicative. Ils sont régis par des relations et des règles d’autorisation qui s’expriment naturellement dans PostgreSQL via les modèles AdonisJS.
ClickHouse gère la télémétrie positionnelle
La table de position utilise MergeTree, avec un tri selon (match_id, game_time, participant). Cette structure suit le modèle d’accès principal de l’utilisateur : un match, une plage horaire et les joueurs qui y participent.
Les observations manquantes sont conservées avec located = 0. Les coordonnées d’une ligne non localisée ne doivent pas être interprétées comme une position réelle. La conservation de ces lignes permet de rendre le dénominateur visible, au lieu de laisser les détections manquantes disparaître complètement du stockage.
La clé de partition actuelle est match_id. Elle facilite le remplacement et la suppression d’un match en supprimant sa partition. C’est aussi un compromis en matière d’évolutivité. Un partitionnement à forte cardinalité génère beaucoup de partitions ; ce n’est pas une recommandation universelle pour un grand stockage de télémétrie partagé. Les conseils de ClickHouse sur les clés de partition donnent le contexte de ce choix.
Je réexaminerais cette stratégie selon le volume réel de matchs, le nombre de parts ClickHouse, la durée de conservation et les besoins de suppression. Un cycle de vie simple par match et des fusions efficaces à grande échelle sont deux préoccupations différentes.
Il n’y a pas de transaction distribuée en jeu ici
Les deux bases de données ne partagent pas de transaction. Le service d’import utilise les états de match importing, ready et failed. Il marque le match comme prêt une fois les insertions de télémétrie terminées ; en cas d’erreur, il enregistre l’échec et tente de nettoyer les données partielles.
Il s’agit là d’un protocole de récupération pratique, et non d’une atomicité entre bases de données. La réimportation supprime l’ancienne télémétrie avant d’insérer la nouvelle. Si le remplacement échoue, l’ancien jeu de données prêt à l’emploi n’est pas automatiquement conservé. Le remplacement simultané mérite également une sérialisation explicite si le produit a besoin de cette garantie.
Ce sont là les détails que je souhaite mettre en évidence dans une explication architecturale. « PostgreSQL plus ClickHouse » semble une formule élégante dans une liste de technologies. C’est dans la coordination de leur comportement en cas de défaillance que commence le véritable travail de conception.
12. Une chronologie nécessite des événements stables
Les événements semblent plus simples que les positions jusqu’à ce qu’un même événement apparaisse à plusieurs reprises, ou que deux événements différents aient des identifiants incomplets.
L’extracteur déduplique les observations répétées. Le correcteur utilise le contenu de l’événement, car une recherche peut réémettre le même événement logique avec un identifiant modifié. Le choix des noms est ici crucial : deux démolitions de tours survenant à peu près au même moment ne doivent pas être fusionnées en un seul événement simplement parce qu’elles ne comportent pas toutes deux un champ « acteur-victime » classique.
Le service d’ingestion dispose d’un mécanisme de secours associé. Il utilise des identifiants d’événement numériques lorsqu’ils sont disponibles et une clé de contenu pour les événements qui en sont dépourvus, en générant des identifiants synthétiques à des fins de stockage. Le type d’événement, l’heure arrondie, les noms et les champs de structure permettent de distinguer les occurrences.
Il n’existe pas de règle d’identification unique et parfaite pour tous les comportements des sources. La leçon à retenir est de modéliser les omissions réelles de la source et son comportement de relecture, plutôt que de supposer que chaque enregistrement possède un identifiant globalement fiable.
Le navigateur utilise ensuite ces événements pour créer des marqueurs temporels et mettre à jour les structures de la carte. La destruction d’une tour n’est pas simplement une ligne dans un journal ; elle modifie ce que la carte doit afficher après ce moment.
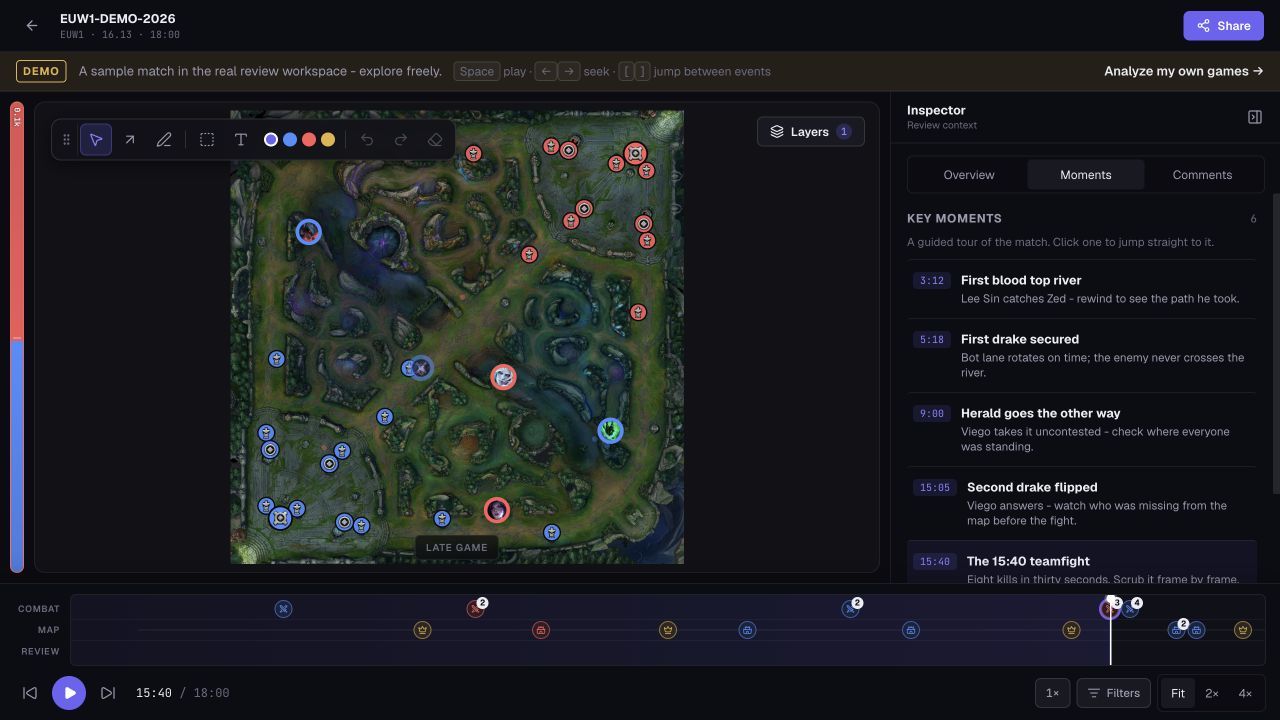
Démonstration publique à 15 min 40 s. Les moments guidés sont des exemples de contenu ; la visionneuse qui les entoure correspond à l’espace de travail de révision réel.
13. La visionneuse dispose d’une seule horloge, mais de plusieurs résolutions
Dans Nuxt, le composable « replay » gère la lecture à partir d’un currentTime, mis à jour via requestAnimationFrame. Les repères sur la carte, les valeurs du tableau de bord, les marqueurs d’événements et le contexte de révision découlent tous de ce moment.
Le partage d’une horloge unique permet d’éviter une catégorie courante de bugs d’interface utilisateur : la carte indique un moment, le tableau de bord un autre, et l’annotation en pointe vers un troisième. Le défilement devient alors un changement d’état avec des consommateurs cohérents.
La source de données est abstraite derrière la même interface, qu’il s’agisse d’un match authentifié ou d’un match partagé. La démo fournit un exemple de bundle via le même mécanisme de révision. C’est pourquoi une démo publique est utile : elle permet de tester l’espace de travail réel sans qu’il soit nécessaire de télécharger au préalable un replay.
Il existe une autre distinction importante en matière de résolution. Le composable Web actuel demande des images par intervalles de cinq secondes et procède à une interpolation pour la lecture. La cible d’échantillonnage d’une demi-seconde de l’extracteur n’est pas la même chose que la densité de requêtes par défaut du navigateur. Une icône se déplaçant de manière fluide ne prouve pas qu’une position a été mesurée à chaque image d’animation rendue.
Pour les rotations de grande ampleur, l’interpolation peut rendre la carte lisible tout en réduisant la charge utile. Pour une analyse précise des mouvements, je préférerais examiner les données sources plus denses et leurs points manquants plutôt que de considérer l’animation à l’écran comme la vérité absolue.
L’API prend également en charge la sélection de champs, les fenêtres sous-échantillonnées et l’itération paginée sur des images complètes. La pagination par images plutôt que par lignes arbitraires de joueurs est importante : le fait de répartir les joueurs d’un horodatage entre plusieurs pages complique la reconstruction pour chaque utilisateur.
Les dessins s’inscrivent dans le contexte de l’analyse
La carte comprend des flèches, des traits à main levée, des rectangles et du texte. Ces dessins permettent d’indiquer un itinéraire alternatif ou de marquer une zone, et ne se limitent pas à pointer une icône en mouvement.
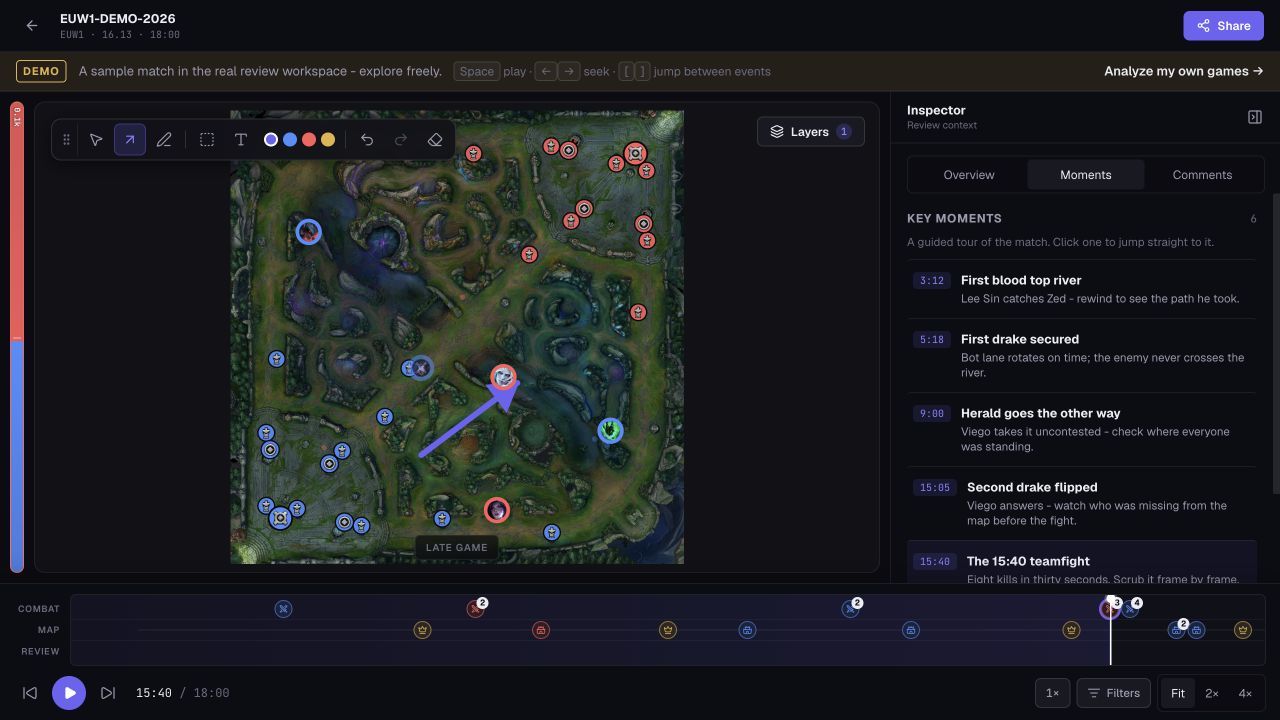
La flèche violette a été dessinée lors de la démonstration en direct réalisée pour cet article. Elle illustre la télestration, et non une trajectoire de joueur détectée automatiquement ni un verdict d’entraînement.
Une petite correction apportée le 14 juillet permet de prendre en compte le type de détails d’interaction qui n’apparaissent pas dans les schémas d’architecture. Les jetons de joueur se trouvaient au-dessus de la surface de dessin SVG et bloquaient les événements de pointeur. Le dessin fonctionnait sur les zones vides de la carte, mais pouvait sembler défectueux lorsqu’il était effectué directement au-dessus d’un champion. La correction transmet les événements de « pointer-down » des jetons au gestionnaire d’annotations lorsqu’un outil de dessin est actif, tout en conservant la sélection normale des joueurs pour l’outil de sélection. La création de texte empêche également l’événement de pointeur d’origine de détourner l’attention de la nouvelle entrée.
La couche de persistance inclut des commentaires horodatés, des cas et des contrôles de partage. Un artefact de révision nécessite plus que des coordonnées : à quelle partie il appartient, quand il s’applique, qui peut le voir et si un destinataire peut le modifier. Ces préoccupations applicatives expliquent pourquoi le volet relationnel du système reste important.
14. Intégration au bureau et API de partie en lecture seule
Le processus principal d’Electron lance l’extracteur en tant que processus fils et analyse les événements de progression délimités par des sauts de ligne. Il met en mémoire tampon des blocs partiels de la sortie standard (stdout), car un flux de processus ne garantit pas un message JSON complet par rappel. La progression est ensuite transmise au moteur de rendu.
La mise à jour des performances du 1er juillet remplace readFileSync par des lectures asynchrones et un analyseur de relecture ligne par ligne. Cela évite de matérialiser l’intégralité d’un fichier volumineux sous forme de chaîne de caractères avant de l’analyser et réduit une source de blocages du processus principal. Il continue toutefois à collecter les enregistrements analysés dans un tableau et à les trier ; je ne qualifierais donc pas le chargeur de relecture de « streaming de bout en bout à mémoire limitée ».
Une réservation synchrone de « démarrage » empêche deux requêtes de démarrage quasi simultanées de passer avant que le processus fils n’existe. Il s’agit d’un petit bout de code ayant un impact important sur l’ergonomie : lancer accidentellement deux extracteurs de relecture est bien pire que de désactiver un bouton pendant un instant.
Le processus de connexion sur ordinateur de bureau utilise un transfert via le navigateur et un code à usage unique. L’API stocke un hachage de ce code et lui attribue une durée de vie de cinq minutes avant son échange. Il s’agit d’un processus dédié à la gestion des comptes ; il ne faut pas le confondre avec la nécessité d’une clé de développeur Riot pour l’extraction.
Ward dispose également d’une API distincte en lecture seule pour les résumés de matchs importés et les données d’analyse. Sa base publique documentée est https://ward.invade.lol/api, sur le domaine web. Le serveur Nuxt valide une clé personnelle et redirige les lectures autorisées vers l’API interne.
Par exemple, depuis un terminal où votre propre clé est définie dans une variable d’environnement :
curl --fail --silent --show-error \
  -H "Authorization: Bearer $INVADE_API_KEY" \
  "https://ward.invade.lol/api/match/list?status=ready&per_page=20"
La clé est affichée une seule fois lors de sa création et stockée sous forme de hachage. Les lectures sont limitées au compte propriétaire. La limite de débit documentée est de 120 requêtes par minute et par clé, avec des compteurs en mémoire par instance. Ce dernier détail est important dans un déploiement à évolutivité horizontale : les limites par instance ne constituent pas un budget global unique.
Les points de terminaison à clé publique excluent intentionnellement l’ensemble complet des données de position par image. Les routes d’images authentifiées et d’exportation répondent à ce cas d’utilisation différent. Un point de terminaison qui renvoie par défaut chaque position, chaque événement, chaque commentaire et chaque annotation devient coûteux pour les consommateurs qui ne souhaitaient qu’une liste de correspondances.
15. Comment je reproduirais et étendrais les mesures
Je distingue trois catégories : les résultats de capture en direct enregistrés, la réanalyse hors ligne et les tests avec des substituts contrôlés. Elles répondent à des questions différentes.
Pour répéter la comparaison des captures, je maintiendrais fixes les paramètres de relecture, de patch, de résolution, d’échelle du HUD, de recadrage, de pas d’échantillonnage, de seuil de confiance, de pondération et d’inférence. Ensuite, je procéderais à la capture à chaque vitesse de lecture dans son propre répertoire de sortie.
Une opération de checkout de la source permet d'accéder aux commandes correspondantes :
python -m extractor "C:\replays\match.rofl" `
  --out .\out\capture-12x --launch --capture-only `
  --capture-mode play --speed 12 --step 0.5
Pour une exécution intégrée qui effectue une analyse après la capture :
python -m extractor "C:\replays\match.rofl" `
  --out .\out\complete-12x --launch --defer-inference `
  --speed 12 --step 0.5 --correct --infer
Répétez la configuration de capture à 8×, 16× et 32×, en utilisant une fonction de relecture compatible et un écran correctement calibré. Conservez les métadonnées et les ensembles de données obtenus. Si vous modifiez les paramètres d’analyse, relancez l’analyse sur ces mêmes ensembles de données afin d’éviter de comparer accidentellement deux séries d’images différentes.
Pour chaque exécution, j’enregistrerais l’occupation de l’écran, le temps total jusqu’au résultat final, les échantillons capturés et rejetés, la couverture à chaque étape du traitement, la composition de la source et la mémoire maximale utilisée. J’inclurais plusieurs exécutions plutôt que de sélectionner la plus rapide.
La fenêtre fixe en milieu de partie mérite d’être conservée, mais j’y ajouterais les combats, les retours à la base, les champions qui se chevauchent et l’état des fontaines des deux équipes. Un ensemble de test annoté manuellement me permettrait de mesurer les erreurs de position réelles et les erreurs d’identification. La couverture à elle seule ne peut pas répondre à ces questions.
Il existe également une vérification du dénominateur qu’il serait utile d’automatiser. Un script par enregistrement devrait compter les emplacements de joueurs, les positions non nulles et chaque source ; séparément, les métadonnées de capture fournissent les pertes de grille. Le fait de mélanger ces métriques en un seul pourcentage rend les régressions plus difficiles à diagnostiquer.
Ce que je comparerais à un échantillon de validation
Pour la prochaine évaluation, je conserverais un ensemble de moments de rediffusion annotés de manière indépendante, en dehors du matériel utilisé pour ajuster les seuils. Je choisirais ces moments avant de lancer une nouvelle configuration, en incluant les cas difficiles au lieu de les écarter après avoir examiné les prédictions. La réutilisation des mêmes lots de capture permettrait d’isoler les changements apportés à l’analyse ; la répétition de la capture en direct constituerait une expérience distincte portant sur l’échantillonnage et le rendu.
L’unité de comparaison serait un joueur à un moment précis de la partie. Un point proche appartenant au mauvais champion reste une erreur d’identité. Je ferais d’abord correspondre l’identité du joueur, j’alignerais les horodatages dans une tolérance définie, puis je mesurerais seulement l’erreur de coordonnées. Permettre à un évaluateur de sélectionner n’importe quel moment voisin donnant la plus petite distance masquerait les problèmes de synchronisation.
Pour les positions dans le même système de coordonnées calibré, la distance de base est :
position_error = sqrt((predicted_x - reference_x)^2
                    + (predicted_y - reference_y)^2)
Je présenterais la médiane et un percentile extrême, ainsi que le nombre d’observations éligibles. Une simple moyenne peut masquer des écarts importants ponctuels, précisément les erreurs qui font paraître une rotation impossible. Les annotations de référence devraient être accompagnées d’une note d’incertitude spécifique : le fait qu’un humain sélectionne le centre d’une icône de mini-carte qui se chevauche ne constitue pas une vérité terrain parfaite dans l’univers du jeu.
Il y a au moins quatre résultats distincts à conserver :
| Question | Mesure que je conserverais |
|---|---|
| La capture a-t-elle respecté le moment prévu ? | Points de grille capturés par rapport aux points de grille prévus |
| Le pipeline a-t-il renvoyé une position ? | Emplacements du joueur localisés par rapport aux emplacements attendus, avec indication du dénominateur |
| La position est-elle associée au bon joueur ? | Erreurs d’identité parmi les cas étiquetés indépendamment |
| À quelle distance la position se trouve-t-elle de la référence ? | Distribution des erreurs spatiales pour les identités et les moments appariés |
Je décomposerais ces résultats en données brutes, corrigées et reconstruites. Comparer uniquement l’erreur des points bruts disponibles à celle de l’ensemble des points reconstruits modifie la population : la reconstruction ajoute délibérément des cas plus complexes. Une comparaison par paires sur les observations communes, associée à un rapport distinct pour les lacunes nouvellement comblées, permet de mettre en évidence cette différence.
Par exemple, imaginons deux configurations qui localisent toutes deux 95 des 100 moments-joueurs étiquetés. L’une permute les identités lors d’un affrontement ; l’autre laisse cinq points manquants mais préserve toutes les identités observées. Leur couverture est identique, mais elles permettent de tirer des conclusions très différentes sur qui a pivoté et où. Il s’agit d’un exemple hypothétique, et non d’un nouveau benchmark de Ward.
Diagnostiquer l’étape avant de modifier le seuil
Lorsqu’une analyse semble erronée, je remonterais en arrière à partir du moment concerné en passant par le visualiseur, les enregistrements importés, le résultat de la reconstruction, les détections brutes et le recadrage enregistré. Chaque étape offre une explication différente :
| Symptôme | Première comparaison que je ferais |
|---|---|
| Un moment entier est manquant | Vérifiez les horodatages prévus par rapport à ceux enregistrés avant d’examiner le niveau de confiance de la détection. |
| Un joueur disparaît au milieu d’un combat animé | Vérifiez le cadrage enregistré et les zones brutes avant de modifier les règles de reconstruction. |
| Un champion change d’identité | Vérifiez les contraintes liées à l’effectif, l’affectation à l’équipe et l’historique des corrections. |
| La plupart des joueurs se déplacent dans la même direction | Vérifiez les limites de recadrage et l’étalonnage avant de réentraîner un détecteur. |
| Les positions semblent systématiquement en avance ou en retard | Comparez l’heure de capture et les instantanés de jeu associés avant d’imputer la faute aux coordonnées. |
| Un parcours devient étrangement fluide | Vérifiez séparément les sources déduites et l’échantillonnage de cinq secondes du visualiseur. |
| Les statistiques locales de sortie et celles du cloud ne concordent pas | Comparez la cartographie de provenance des données ingérées et les indicateurs de positions manquantes. |
Il s’agit là de points de départ pour le diagnostic, et non de causes uniques. Leur intérêt réside dans le fait qu’ils permettent de cibler la prochaine expérience. Augmenter le niveau de confiance ne permet pas de corriger une capture manquante, et ajouter une interpolation ne permet pas de corriger une transformation de coordonnées qui décale chaque observation. Conserver les artefacts intermédiaires me permet d’étudier la couche qui a réellement introduit l’erreur.
Ce que les tests automatisés permettent d’établir
Les tests hors ligne couvrent la transformation, l’assemblage des enregistrements, l’écriture chronologique, le comportement en cas de perte de données, la correction, la reconstruction, les bundles et les chemins d’erreur via des interfaces de relecture substituée, de capture et de modélisation. Ils permettent de vérifier que le pipeline répond correctement à des entrées contrôlées. Ils ne permettent pas de certifier un nouveau patch League, la fidélité réelle des captures d’écran ou les performances du GPU.
Cette distinction est utile plutôt que décevante. Des tests déterministes rapides protègent la logique ; des expériences en temps réel valident le système externe dont dépend cette logique.
16. Ce que ce projet m’a appris
Les gains les plus importants ont été obtenus en déplaçant les tâches appropriées d’un niveau à l’autre. L’optimisation d’un modèle facilite l’inférence. La suppression des recherches modifie le goulot d’étranglement de la relecture. Le passage de l’inférence en hors ligne modifie la durée d’occupation de l’écran de l’utilisateur. La suppression du protocole HTTP de la boucle critique préserve la densité d’échantillonnage. Il s’agit d’améliorations liées entre elles, mais elles ne sont pas interchangeables.
Il en va de même pour la qualité des données. Le filtrage selon la composition réduit les identités impossibles. L’étalonnage corrige les erreurs systématiques de coordonnées. La correction temporelle corrige les incohérences de courte durée. La reconstruction fournit des estimations là où des observations manquent. Garder l’origine de chaque position visible rend le résultat utile à quelqu’un qui souhaite l’analyser sérieusement.
J’ai également dû appliquer cette rigueur au produit. Un extracteur peut produire de bons fichiers tout en restant peu pratique à utiliser. La progression du traitement, la connexion, la récupération des importations, la navigation entre les événements et les annotations sont les éléments qui transforment ces fichiers en quelque chose avec lequel une autre personne peut travailler.
Ward réunit tous les aspects du développement qui me passionnent : un problème concret lié au produit, une source de données complexe, et suffisamment de travail côté front-end et back-end pour rendre le résultat accessible. Si vous souhaitez découvrir l’interface, essayez la démo publique de Ward. Si vous développez une application comportant des intégrations ou des pipelines de données tout aussi complexes, vous pouvez me contacter pour une mission en freelance.
FAQ sur l’extraction ROFL
Ward peut-il convertir directement un fichier ROFL en JSON sans League ?
Le processus d’extraction décrit ici nécessite League pour lire la rediffusion sous Windows. Il lit l’état local de la partie et détecte les positions à partir de la mini-carte affichée. Une fois le bundle de capture créé, l’analyse hors ligne peut s’exécuter sans relancer le ROFL.
L’extraction ROFL nécessite-t-elle une clé API Riot ?
Cette méthode d’extraction locale ne nécessite pas de clé développeur Riot publique. Elle utilise les API locales Live Client Data et Replay. Une clé de compte Ward est un identifiant distinct permettant de lire vos données de match importées via l’API publique de Ward.
Peut-elle traiter un ancien replay de League ?
Uniquement si un client compatible peut le lire. Un ensemble de captures déjà enregistré évite cette dépendance vis-à-vis de la rediffusion pour les analyses ultérieures, car les images et les instantanés associés ont déjà été enregistrés.
Une couverture de 98 % signifie-t-elle que les positions sont précises à 98 % ?
Non. Dans le benchmark enregistré, la couverture mesure la présence de positions parmi les images des joueurs capturées. Elle inclut les positions reconstruites et exclut les images manquantes de son dénominateur. La précision spatiale nécessite des positions de référence indépendantes.
Pourquoi ne pas extraire chaque replay à une vitesse de 32× ?
Le balayage enregistré présente une durée d’affichage plus courte, mais davantage de points de grille perdus et une couverture visuelle moins bonne, en particulier lors d’une phase intense en milieu de partie. Le chemin différé automatique actuel privilégie une limite de 12× et peut s’adapter jusqu’à 16× pour les longues parties.
L’extracteur retrouve-t-il toutes les wards placées ?
Le pipeline décrit ici extrait les positions des champions ainsi que les événements et l’état des joueurs disponibles. Le score de vision d’un joueur ne fournit pas les coordonnées de chaque ward. Je ne prétends donc pas suivre exhaustivement leur placement et leur expiration.
Puis-je analyser un match sur un Mac ou dans un navigateur ?
L'étape de capture décrite ici nécessite Windows et League. L'étape d'analyse Web s'appuie sur les données extraites ; le navigateur n'a donc pas besoin d'exécuter le client de relecture.
Références techniques et provenance des mesures
Les captures montrent la démo publique telle qu’elle apparaissait le 21 septembre 2026. Les chiffres proviennent des notes de benchmark du projet. Les chemins ci-dessous indiquent les fichiers qui portent les différentes parties du pipeline.
apps/extractor/BENCHMARK_ONSCREEN_TIME.md: balayage de capture du 1er juillet 2026, environnement de test, couverture de l’intégralité du match et en mode fenêtré, ainsi que la répartition des sources.extractor/pipeline.py,bundle.pyetanalyze_bundle.py: planification, lectures en arrière-plan, capture, écriture ordonnée et analyse hors ligne.extractor/detect.py,onnx_backend.py,geometry.py,correct.pyetreconstruct.py: intégration du modèle, taille d’entrée, calibration, correction et provenance des positions inférées.apps/api/app/services/match_ingest_service.ts,clickhouse_schema.tsetmatch_query_service.ts: import en continu, schéma de stockage, cycle de vie et requêtes.apps/desktop/src/main/extractor.ts,apps/web/app/composables/useReplay.tsetdocs/public-match-api.md: paramètres actuels de l’application desktop, lecture dans le navigateur et limites de l’API par clé de compte.- Riot Games : interfaces du client de jeu, ONNX Runtime : DirectML, fiche du modèle de détection et ClickHouse : choix des clés de partition.